電子製造業的零件尺寸較小、生産周期較短,使得設備及産品的異常診斷能力變得非常重要,其辨識能力的強弱甚至成爲了企業競爭力的一部分。如何快速、高效地識別這些異常,以及做好提前預警和分析,是提高良率不可或缺的一大環節。
今天我們以電子製造行業的一個案例爲例,來看看如何透過JMP強大的神經網絡建模與資料視覺化,幫助數據分析人員大幅减少異常芯片的識別與偵測時間,幫助企業提高生產效率與品質。
爲什麽資料分析如此重要?
品質對於高科技企業來說,意味著製造成本、出貨周期和品牌價值。所以幾乎每家企業都把產品品質看作重中之重。那麽如何改善企業產品品質變成是一項艱巨的任務。
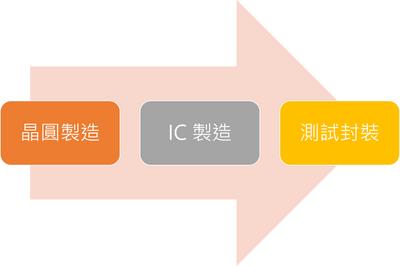
(圖二) 是常見的高科技/類企業的典型生産步驟,其中:
1. 晶圓製造
晶圓製造是指半導體集成電路製作所用的矽晶片,由于其形狀爲圓形,故稱爲晶圓;在矽晶片上可加工製作成各種電路元件結構,而成爲有特定電性功能的集成電路産品。
2. 封裝測試
封裝是將通過測試的晶圓按照産品類型及功能需求加工得到獨立芯片的過程;測試則是通過一系列的檢測項目來偵測每顆獨立芯片的好壞的過程。
特別是在「測試」環節,傳統方法是使用人工識別,即透過個人判斷將有問題的晶圓圖一一記錄下來,再做後續處理工作。然而實際工作中,人工識別常常會面臨以下3個問題:
1. 漏檢圖形
每個人在面臨上百張晶圓檢測圖的時候,幾乎不可能做到每張圖一一過目,很可能因為過於疲勞等因素錯過了一些重要的圖形,而這些圖形往往蘊藏著重要訊息。
2.耗時過長
整個人工辨識過程非常耗時,沒有將時間用在解决核心問題上。
3.標準不統一
對於沒有出現過的圖形,判斷標準會隨著個人的標準不同有所差異,容易造成潛在訊息的丟失。
基於以上這些不可避免的因素,JMP 視覺化分析就派得上用場了。
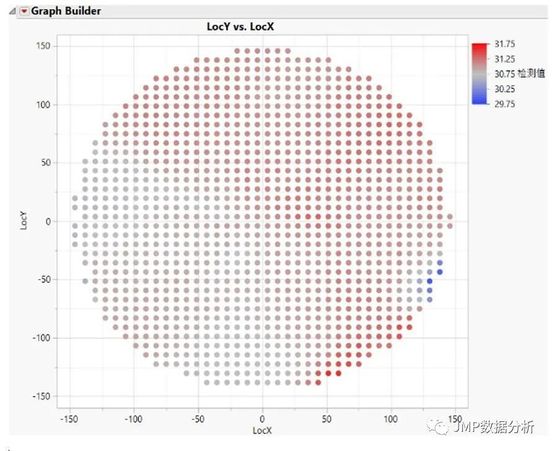
例如,我們把每顆獨立芯片的檢測結果按照它們在晶圓上面的位置一一對應,所得的檢測結果匯入到JMP,透過JMP圖形生成器就可以輕鬆生成以下的晶圓檢測圖,從而快速地識別出有問題的産品,如圖三。
圖三
其中,不同顔色代表著最終測試檢測值的大小。紅色最大,依次遞减,藍色最小。
從上圖三可以看到,晶圓右下方藍色部分的檢測值偏低。這代表什麽意思呢?意思是在晶圓製造時,這一區域有異常,需要儘快調查及解决。這樣工程師就可以馬上著手針對這類有問題的芯片進行快速跟進了。我們這裡舉個實例做說明。

案例分析:使用JMP快速識別晶圓缺陷
案例背景
某電子企業的工程師在最終測試階段收集到了1559個芯片的缺陷數據,想分析其中某一項缺陷的比率隨著位置的變化是否呈現規律。
- 如果某一位置的缺陷率爲‘0’,代表在這個位置沒有出現過這項缺陷。
- 如果在這個位置的缺陷率很高,則表明,次品集中在這個位置。
透過這種缺陷圖形的尋找,最終爲前道諸多工序建立另一種質量偵測手段或者指標,可以作爲整體質量提升的突破。
圖四
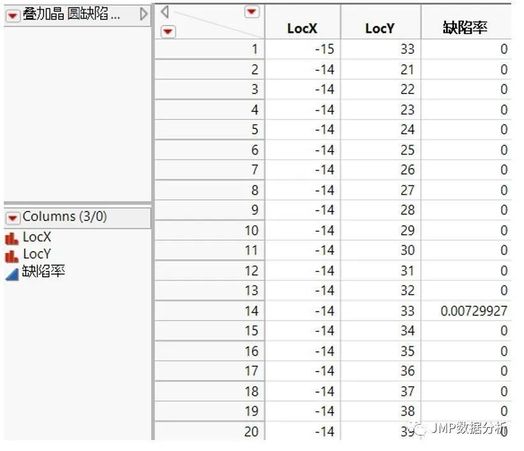
在圖四數據表中,LocX和LocY列分別是行、列坐標值,數值類型爲名義值。最後一列爲缺陷率,即在過去一段時間內某一位置出現缺陷的比率。爲了更好地判斷問題,我們在這裡選擇神經網路算法。原因有以下幾點:
- 專案需要算法能夠從原始數據中自動發現需要檢測的特徵。
- 神經網路的算法一般都有多個層次,每一個層次做一次變換,這樣可以有多次機會抓取不同特徵。
- 通常來說,用來做訓練的數據量越多,可以更好地提高其準確性。
接下來就來解釋如何在JMP中一步步進行分析。
Step1. 數據導入JMP
首先,將數據導入JMP,把收集到的位置缺陷率轉換爲數據值幷通過圖形生成器來呈現。
打開JMP -> 分析(Analyze) -> 預測建模(Predictive modeling) -> 神經(Neural),把需要觀測的缺陷率放在「Y,Response」,把Loc X和Loc Y放入「X,Factor」,如下圖五:
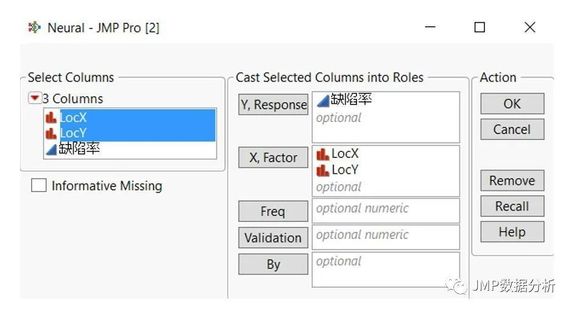
圖五
進入模型配置窗口,按照以下參數輸入。本例從默認的神經網絡模型開始,逐步增加更複雜的模型有兩個隱藏層和其他的激活函數。最終選定以下配置,如圖六:
在fitting option部分,告訴JMP重複多少次模型擬合算法。最終JMP會選擇具有最佳驗證統計量的迭代作爲最終模型。本文最終使用10.
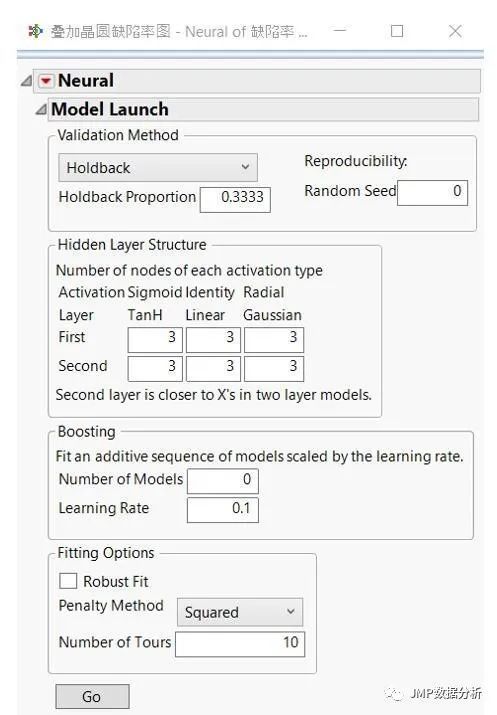
圖六
點擊Model左邊紅色小箭頭,選擇保存公式(Save Formulas),主要是爲了存儲變換之後的數值以備用。
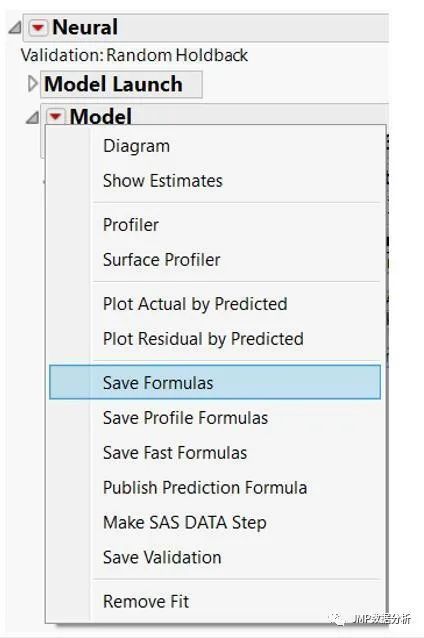
圖七
這樣經過行列轉換後,得到以下新的數據表,如圖八:
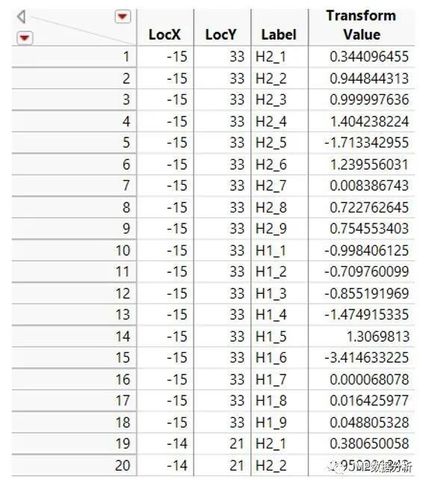
圖八
如果用圖形來簡單說明轉換過程的話,就如下圖九所示:
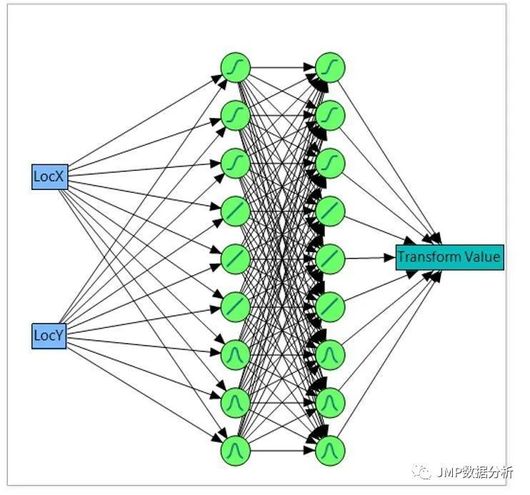
圖九
Step2. 使用JMP圖形生成器分析
接下來,應用JMP 獨有的「圖形生成器(Graph Builder)」進行分析。
這裏我們將LocX放到橫軸,LocY放到縱軸,Transform Value放到右上角的Color中,點擊Graph Builder下面的紅色小箭頭,選擇Local Data Filter,如圖十:
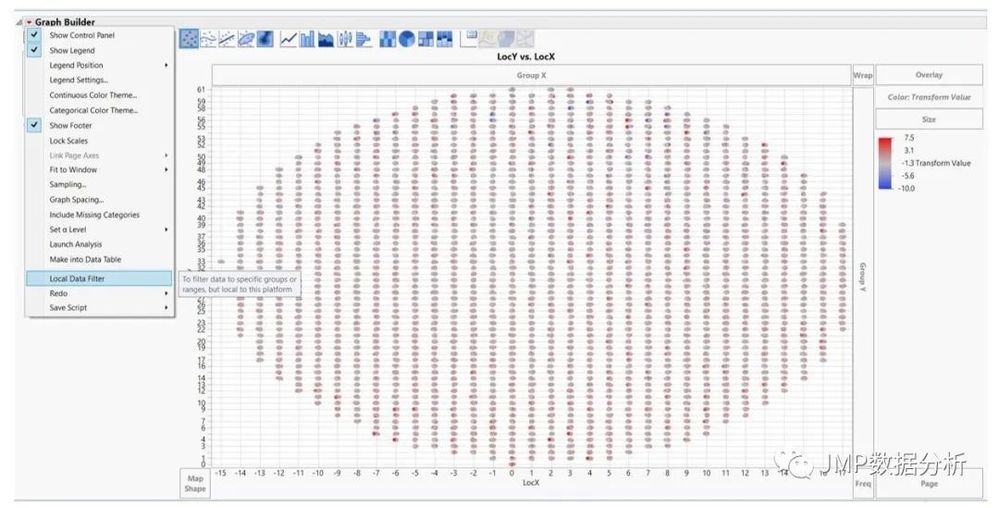
圖十
在Local Data Filter下選擇Label:

圖十一
然後,再選擇紅色小箭頭——「Animation」,得到以下動態圖形:
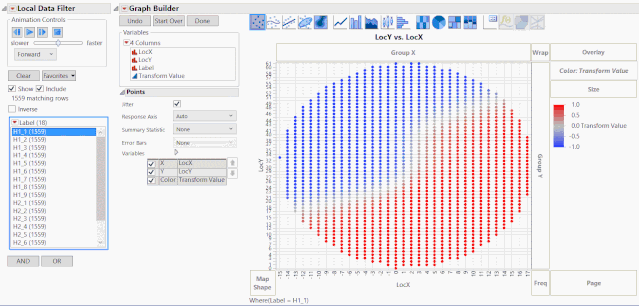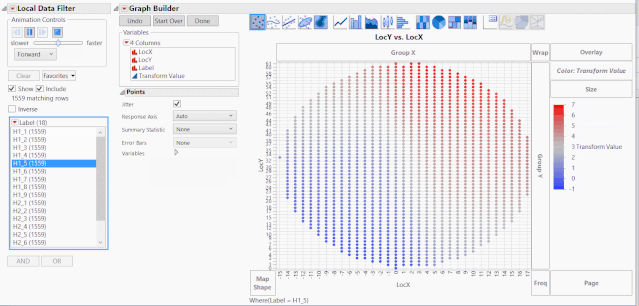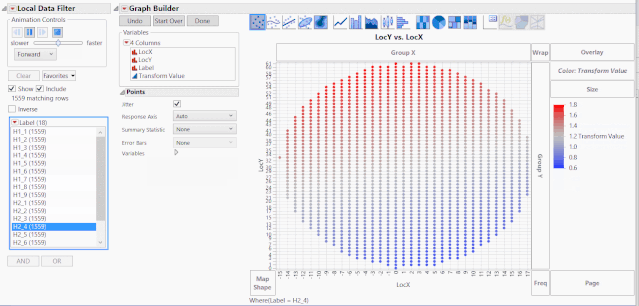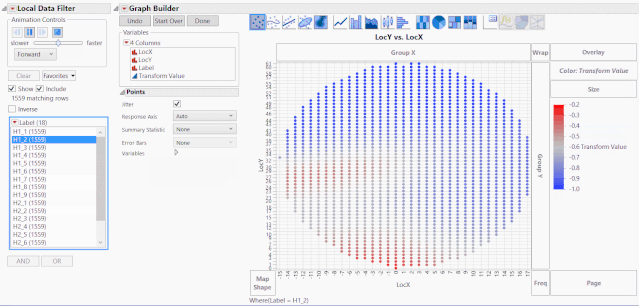
這個動圖主要展示了JMP在內部運算過程中是如何逐一掃描整個wafer,最終找到最優解的過程。其中H1_1是指第一個隱藏層的第一個節點,以此類推。
這就是在模型構建層面我們的思路和策略。那麽,具體到實際項目的應用層面,應該怎麽部署和分析呢?我們來繼續探討。
JMP 落地應用:專案部署及實際成效
按照上面JMP生成的模型,接下來我們就可以部署在應用層面。
在部署層面,實際上我們只需要建立一個ranking model,即排序模型。這個模型不需要保證每一個計算結果都非常精確,最重要的是能够在多個wafer map中抓到最顯著的圖形即可。由于數據量較大以及服務器是Linux系統(相對穩定),故而采用python程序從數據庫中提取數據,根據以上神經網絡方法把有問題的wafer map按照RSquare排序。
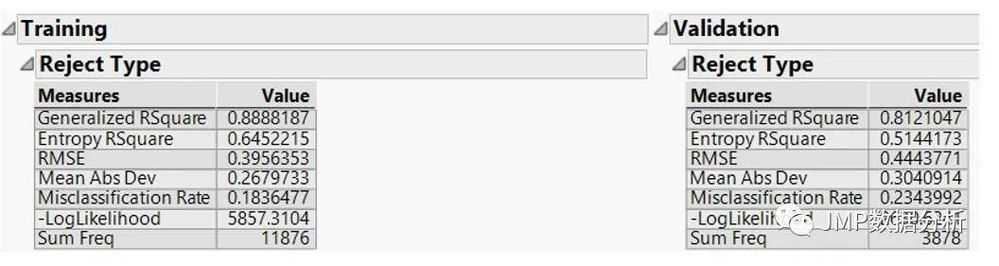
圖十四
之所以選擇RSquare排序,是想按照模型的顯著性來代表是否抓到了pattern。
即模型越顯著,代表著抓到pattern的可能性越大。
關於Generalized R-Square如何計算(截圖所示),可參考之前的文章《提速增效,神經網路助力企業運營更高效》
舉例如下,這裏有以下7類次品(從Defect A到Defect G),每一行代表wafer map上X,Y坐標,以及在相應坐標位置上不同次品類型分別累計(某一周)的缺陷率。
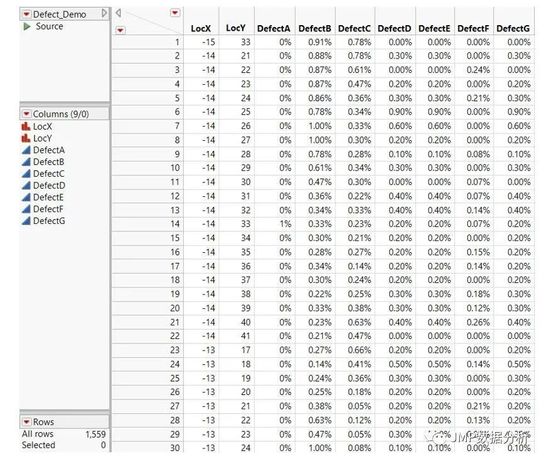
圖十五
按照上一節介紹的算法以及RSquare排序如下,這時我們發現Defect C和Defect A是所有類型的次品中值最高的(如果定義閾值爲>0.7的話,當然閾值可以根據案例自己定義)。

圖十六
那麽經過Graph Builder 生成的Defect C和Defect A次品圖形確實非常值得研究,而值最低的Defect D,經過Graph Builder畫出wafer map後圖形確實不明顯。
Defect C(RSquare值高)-右側邊緣圖形:
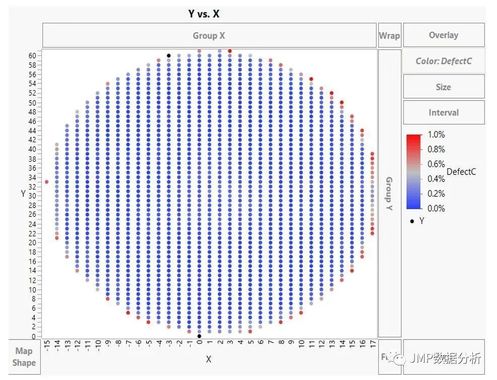
圖十七
Defect A(RSsquare值高)-中心右上方圖形:
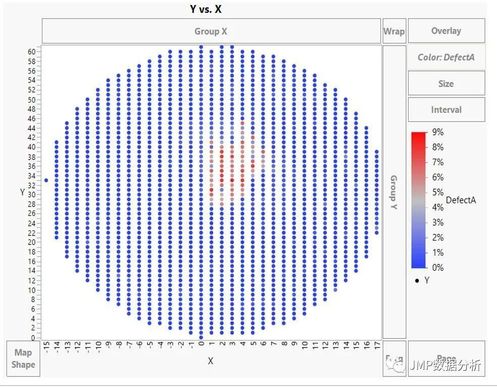
圖十八
Defect D(RSsquare值低)-幾乎看不出圖形

圖十九
以下是系統架構示意圖:
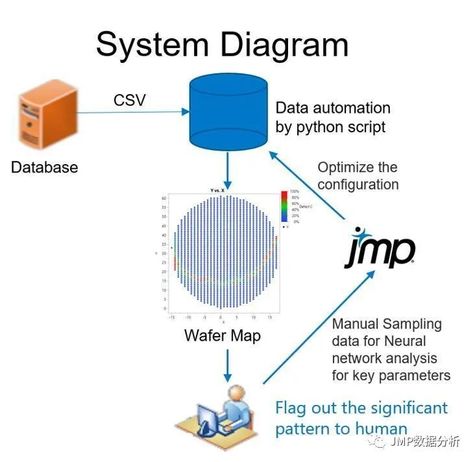
圖二十
需要注意的是,根據樣本數據,通過JMP計算,需要每個月爲模型更新第一層和第二層layer中的節點數(比如對于新出現的pattern,當前配置是否可以識別到,需要考慮調整節點數等),以便使模型的計算更加有效。
通過這個方法,經實際操作後,證明企業中每名數據分析人員平均每周减少60%的圖形識別時間,而且異常圖形平均偵測時間累計較以前縮短70%,爲品質管控整體水平提升做出了巨大的貢獻。
透過上述實戰案例我們可以看到,産品的良率偵測僅僅依靠人工不僅耗時耗力,還容易出現錯誤、漏檢等情况,而重要的品質風險却往往隱藏在某些人工無法識別的地方。
這就好比一座冰山,人們往往關注露出水面部分的問題,但是水面以下的部分往往由于各種原因沒有辦法看到。透過先進的數據分析與技術,可以有效地解决問題,並將人工精力更多地放在解决問題上,從根本上節省了品質偵測的周期時間。
坐而言不如起而行,實際試用JMP,開始你的第一個分析吧!
延伸閱讀:
5個理由告訴你,為什麼JMP軟體更適合你?
浅析SPC之異常分析
SPC管制產品良率——分位數法設定產品管制限與定期回顧
運用JMP淨化離群值,以半導體分析WAT資料為例
You must be a registered user to add a comment. If you've already registered, sign in. Otherwise, register and sign in.